
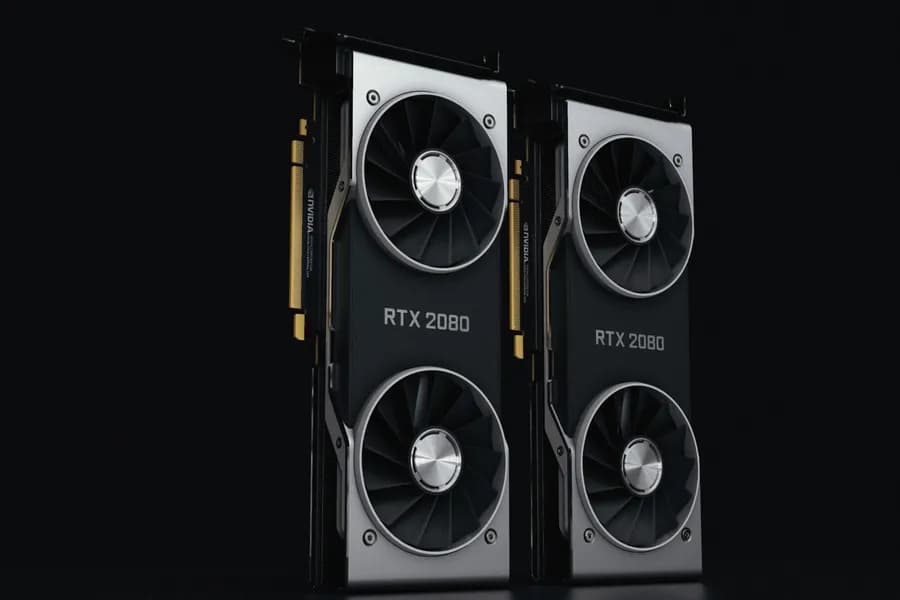
NVIDIA GRID GPU
Paylaştırılmış NVIDIA GRID ekran kartıyla model eğitimi ve inference işlerinizi hızlandırın.
NVIDIA GRID GPU destekli VDS sunucu. PyTorch, TensorFlow, Stable Diffusion, LLM inference için. Türkiye lokasyonu, KVKK uyumlu. ₺500/ay'dan.
GPU VDS PaketleriYapay zeka iş yükleri büyük ölçüde GPU'ya ihtiyaç duyar. CPU'da çalışan bir model GPU'da 50-100 kat hızlanır. Büyükweb iki tip GPU çözümü sunar: GPU VDS(NVIDIA GRID sanallaştırılmış GPU) ve Fiziksel GPU Sunucu(AMD Ryzen APU). Her iki çözüm farklı kullanım senaryolarına hitap eder.
| İş Yükü | Önerilen Sunucu | Sebep |
|---|---|---|
| Stable Diffusion (image gen) | GPU VDS | 8 GB+ VRAM, NVIDIA GRID yeterli |
| 7B-13B LLM inference | GPU VDS Pro | Quantize ile 8-16 GB VRAM yeterli |
| Whisper / TTS / Speech | GPU VDS | Düşük-orta VRAM yeterli |
| Computer Vision Eğitim | Fiziksel GPU Sunucu | Tam VRAM erişimi, çoklu epoch |
| 70B+ LLM, büyük training | Özel kurulum | A100/H100 sınıfı GPU gerekir |
| Agent / RAG / API gateway | CPU VDS | LLM'ler API'den çağrılıyorsa GPU gereksiz |
Stable Diffusion 1.5, SDXL, FLUX modelleriyle üretim. AUTOMATIC1111, ComfyUI, InvokeAI web UI'leri.
Llama 3, Mistral, Qwen, DeepSeek modellerini Ollama veya vLLM ile self-host. RAG ile özel veri sorgulama.
Whisper ile speech-to-text, XTTS ile text-to-speech, Bark, ElevenLabs alternatifleri.
Stable Video Diffusion, AnimateDiff, video upscaling, frame interpolation.
YOLO object detection, FaceNet face recognition, OCR (PaddleOCR, EasyOCR), classification.
PyTorch, TensorFlow, scikit-learn, XGBoost ile model eğitim ve hyperparameter tuning.
sentence-transformers, BGE, E5 modelleri ile özel embedding API. Vektör veritabanları (Qdrant, Weaviate).
LangChain, LlamaIndex, CrewAI, AutoGPT için API host. Tool calling ve action loop'ları.
KVKK Uyumu: AI uygulamalarının çoğu kişisel veri (fotoğraf, ses, metin) işler. Verilerin yurt içinde tutulması KVKK 9. madde ile uyumludur. Yurt dışı büyük bulut sağlayıcılarında çalışan modellerde transfer veri akışı gerekçesiyle ek hukuki süreçler gerekebilir.
Düşük Gecikme: Türk kullanıcılara hizmet veren chatbot ve AI asistan'larda 50ms gecikme UX'i ciddi etkiler. İstanbul lokasyonu Türkiye için 1-5ms gecikme sunar; ABD lokasyonlu sunucularla 100-150ms farkı.
# 1. NVIDIA driver durumu
nvidia-smi

# 2. Conda kur
wget https://repo.anaconda.com/archive/Anaconda3-latest-Linux-x86_64.sh
bash Anaconda3-latest-Linux-x86_64.sh

# 3. PyTorch + CUDA
conda install pytorch torchvision torchaudio pytorch-cuda=12.1 -c pytorch -c nvidia

# 4. Test
python -c "import torch; print(torch.cuda.is_available())"

# 5. Stable Diffusion (AUTOMATIC1111)
git clone https://github.com/AUTOMATIC1111/stable-diffusion-webui
cd stable-diffusion-webui && ./webui.sh --listen

# Veya Ollama (LLM)
curl -fsSL https://ollama.com/install.sh | sh
ollama run llama3.1
Büyük modelleri sınırlı VRAM'e sahip bir GPU VDS üzerinde çalıştırmanın veya eğitmenin en etkili iki yolu quantization (nicemleme) ve LoRA/QLoRA tabanlı fine-tuning'dir. İkisi de aynı donanımdan çok daha fazla verim almanızı sağlar.
Quantization, model ağırlıklarının hassasiyetini (precision) düşürerek bellek ihtiyacını azaltır. Varsayılan FP16 formatındaki bir model INT8'e (8-bit tam sayı) nicemlendiğinde VRAM ihtiyacı yaklaşık yarıya, INT4'e (4-bit, genelde GGUF dosya formatında dağıtılır) nicemlendiğinde ise dörtte birine kadar iner. Yukarıdaki VRAM tablosunda bunu somut olarak görebilirsiniz: 7B parametreli bir LLM FP16'da ~14 GB VRAM isterken, INT8'de ~7 GB'a, INT4/GGUF'ta ~4 GB'a düşer; 13B model FP16'da ~26 GB isterken INT4/GGUF'ta ~7-8 GB'a kadar iner.
| Format | Bit Genişliği | Kalite Etkisi | Ne Zaman Kullanılır |
|---|---|---|---|
| FP16 | 16-bit | Kayıp yok (referans) | VRAM bol, maksimum doğruluk gerektiğinde |
| INT8 | 8-bit | Gözle görülmez düzeyde | Üretim ortamı, dengeli VRAM tasarrufu |
| INT4 / GGUF | 4-bit | Hafif, görev bağımlı | Düşük VRAM'li GPU VDS, sohbet/asistan senaryoları |
Tam fine-tuning (full fine-tuning), bir modelin tüm parametrelerini ve optimizer durumlarını günceller; bu da modelin kendisinden kat kat fazla VRAM gerektirir ve büyük modellerde pratik değildir. LoRA (Low-Rank Adaptation) bunun yerine temel model ağırlıklarını dondurup yalnızca küçük "rank-decomposition" matrislerini eğitir — bu matrisler orijinal parametre sayısının genelde yüzde birinden azını oluşturur.
QLoRA bir adım daha ileri gider: temel modeli 4-bit'e quantize edip üzerine LoRA adaptörleri eğitir. Bu kombinasyon sayesinde 7B-13B parametreli bir modeli, tam fine-tuning'in gerektirdiği donanımın çok altında, orta seviye bir GPU VDS üzerinde fine-tune etmek mümkün hale gelir.
Doğru quantization seviyesi kullanım senaryonuza göre değişir. Sohbet botu, özetleme veya genel asistan görevlerinde Q4_K_M gibi dengeli GGUF formatları hem VRAM tasarrufu hem kabul edilebilir kalite sunar. Hukuki metin analizi, tıbbi özetleme veya kod üretimi gibi hassasiyetin kritik olduğu görevlerde INT8 veya FP16 tercih edilmelidir — VRAM maliyeti daha yüksektir ama çıktı güvenilirliği artar. Stable Diffusion gibi görüntü üretim modellerinde ise mimari farklı olduğundan quantization daha sınırlı fayda sağlar; bu modeller genelde FP16 hassasiyetle çalıştırılır.
Bir yapay zeka özelliğini hayata geçirirken iki temel yol vardır: modeli kendi GPU VDS'inizde barındırıp doğrudan çalıştırmak veya üçüncü taraf bulut AI API hizmetlerini istek başına çağırarak kullanmak. Doğru seçim büyük ölçüde kullanım hacminize bağlıdır.
İki modelin maliyet eğrileri farklı eğimlerdedir: API'de toplam maliyet istek hacmiyle doğru orantılı artarken, GPU VDS'te maliyet sabittir. Düşük hacimde API daha ucuzdur; hacim belli bir eşiği aştığında eğriler kesişir ve bu noktadan sonra kendi sunucunuzda çalıştırmak daha ekonomik hale gelir. Sürekli çalışan bir chatbot, arka planda toplu içerik üreten bir pipeline veya günde binlerce isteği karşılayan bir uygulama genelde bu eşiğin üzerindedir.
İki yaklaşımı bir arada kullanmak da mümkündür: düşük öncelikli veya deneysel özellikleri API üzerinden test edip, hacmi kanıtlanmış ve sürekli çalışan iş yüklerini kendi GPU VDS'inize taşıyabilirsiniz. Bu hibrit strateji hem esneklik hem de maliyet kontrolü sağlar.
Yapay zeka uygulamalarının büyük çoğunluğu kişisel veri işler: bir chatbot kullanıcı mesajlarını, bir görüntü işleme servisi fotoğrafları, bir ses asistanı ses kayıtlarını modele girdi olarak gönderir. Bu veri akışının nereye gittiği, KVKK açısından sadece "nerede barındığınız" sorusundan ibaret değildir; veri sorumlusu olarak birkaç ayrı yükümlülüğünüz daha vardır.
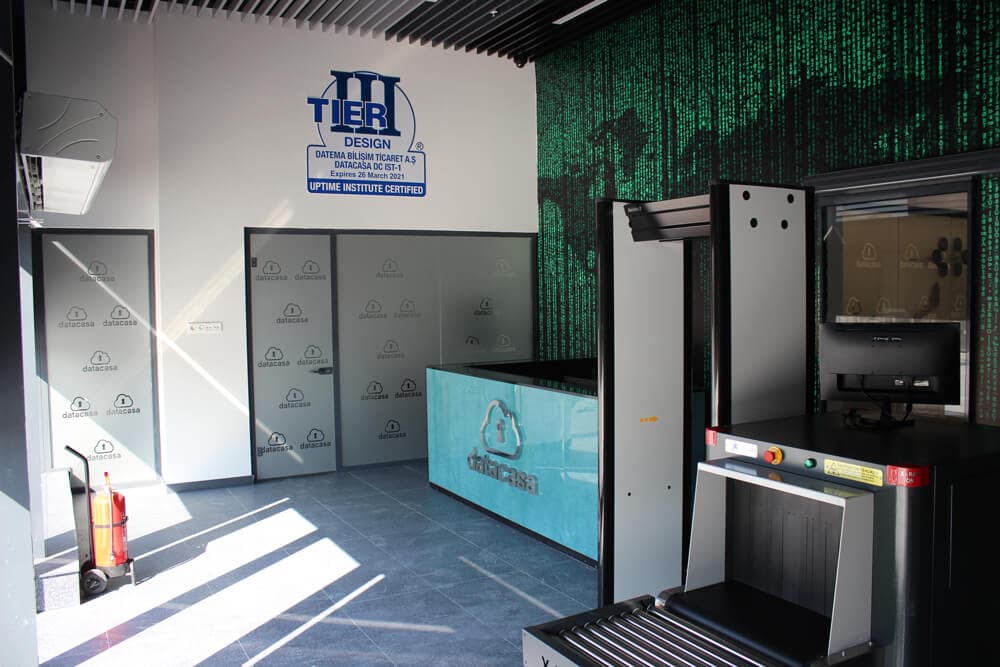
KVKK madde 9, kişisel verinin yurt dışına aktarılmasını açık rıza veya Kurul'un belirlediği istisnai şartlara (yeterli korumaya sahip ülke, yazılı taahhüt vb.) bağlar. Yapay zeka isteğinizi yurt dışında barınan bir API'ye gönderdiğinizde, isteğin içeriğindeki kişisel veri de fiilen yurt dışına aktarılmış olur ve bu yükümlülükler devreye girer. GPU VDS'iniz İstanbul Tier III sertifikalı DataCasa veri merkezinde barındığı ve modeli kendi sunucunuzda çalıştırdığınız için veri sınır ötesine hiç çıkmaz; madde 9 kapsamındaki aktarım yükümlülüğü bu senaryoda oluşmaz.
Veri sınır içinde kalsa da veri sorumlusu sıfatınız değişmez. KVKK madde 10 uyarınca kullanıcılara hangi verinin (metin, ses, görüntü), hangi amaçla (örn. öneri üretme, otomatik yanıt) işlendiğini açıklayan bir aydınlatma metni sunmanız gerekir. Ses kaydından duygu analizi, kamera görüntüsünden yüz tanıma gibi özel nitelikli kişisel veri işleyen uygulamalarda ise KVKK madde 6 gereği ayrıca açık rıza alınması zorunludur.
Belirli ölçeğin üzerinde veri işleyen şirketlerin Veri Sorumluları Sicil Bilgi Sistemi'ne (VERBİS) kayıt olması ve veri işleme envanterinde yeni eklenen AI işleme faaliyetlerini (hangi veri kategorisi, hangi amaçla, ne kadar süre saklandığı) güncel tutması gerekir. Kendi sunucunuzda çalışan bir model için bu envanteri hazırlamak, üçüncü taraf bir API'nin iç işleyişini belgelemeye çalışmaktan çok daha nettir; çünkü veri akışının tamamı sizin kontrolünüzdedir.
Üçüncü taraf bir AI API kullandığınızda, o sağlayıcı KVKK anlamında "veri işleyen" konumuna geçer ve aranızda bu ilişkiyi düzenleyen bir sözleşme/madde bulunması gerekir; ayrıca sağlayıcının kendi güvenlik önlemlerini de üstlenmiş olursunuz. Modeli kendi GPU VDS'inizde çalıştırdığınızda bu zincir kısalır: veri sorumlusu ve veri işleyen aynı kontrol altındaki altyapıdır, ek sözleşme yönetimi yükü ortadan kalkar. Ayrıca silme talepleri (unutulma hakkı) gibi ilgili kişi haklarını doğrudan kendi loglarınız ve veritabanınız üzerinde uygulayabilirsiniz.
KVKK madde 12 gereği, işlediğiniz kişisel verilerin yetkisiz kişilerce ele geçirildiğini öğrendiğiniz andan itibaren en geç 72 saat içinde Kişisel Verileri Koruma Kurulu'na bildirim yapmanız, etkilenen kişileri de en kısa sürede uygun yöntemlerle bilgilendirmeniz gerekir. Yapay zeka uygulamanız kendi GPU VDS'inizde çalıştığında hangi verinin, hangi zaman aralığında, hangi bileşende işlendiğini kendi loglarınızdan net şekilde tespit edebilir; bu da olası bir ihlal durumunda bildirim sürecini hızlandırır ve kapsamı doğru belirlemenizi sağlar.
Çoğu yapay zeka projesi tek bir GPU VDS ile başlar: prototip geliştirilir, model test edilir, ilk kullanıcılara açılır. Trafik büyüdükçe hangi aşamada ve nasıl ölçeklendirme yapılacağını bilmek, hem performansı korur hem gereksiz maliyeti önler.
Bu sinyalleri gözle takip etmek yerine sistematik izlemek daha güvenilirdir. GPU kullanım oranı, VRAM doluluğu, ortalama yanıt süresi ve istek kuyruğu derinliği gibi metrikleri Prometheus + Grafana gibi açık kaynak izleme araçlarıyla panel haline getirip eşik değerler için uyarı (alert) kurmak, kapasite sorununu kullanıcılar fark etmeden önce görmenizi sağlar. nvidia-smi çıktısı da script ile periyodik olarak toplanıp bu panele beslenebilir.
İlk adım genelde dikey ölçeklendirmedir: daha yüksek CPU/RAM/VRAM kapasiteli bir üst GPU VDS paketine geçmek. Tek sunucu kapasitesi yetmemeye başladığında yatay ölçeklendirmeye geçilir — birden fazla GPU VDS paralel çalıştırılır ve gelen istekler bir load balancer (Nginx, HAProxy) ile bu sunuculara dağıtılır. Bu, "data parallelism" mantığına benzer: model her sunucuda aynı şekilde kopyalanır, farklı istekler paralel işlenir.
Tek bir GPU üzerinde verimi artırmanın bir başka yolu batch inferencedir: gelen birden fazla isteği tek seferde GPU'ya vererek donanımı daha verimli kullanmak. vLLM gibi inference sunucuları "continuous batching" tekniğiyle bunu otomatik yapar ve aynı donanımdan çok daha yüksek throughput (saniyede işlenen istek sayısı) elde edilmesini sağlar.
Yukarıdaki teknikler modelin tek bir GPU'ya sığdığı senaryolar içindir. 70B+ parametreli çok büyük bir modelin kendisi tek GPU'nun VRAM'ine sığmıyorsa, model katmanları birden fazla GPU'ya bölünerek çalıştırılır — buna model parallelism denir. Bu senaryo, GPU VDS'in paylaşımlı vGPU mimarisinin ötesine geçer ve tam VRAM erişimi sunan Fiziksel GPU Sunucu gerektirir. Benzer şekilde çoklu GPU ile paralel model eğitimi (multi-GPU training) de fiziksel sunucu altyapısı ister.
Ölçeklendirme kararını verirken tek bir metriğe değil, birkaç göstergenin birlikte değerlendirilmesine dikkat edin. Örneğin GPU kullanım oranı yüksek ama yanıt süreniz hâlâ kabul edilebilir seviyedeyse, önce batch boyutunu ve continuous batching ayarlarını optimize ederek mevcut donanımdan daha fazla verim alabilirsiniz; donanım yükseltmesi ancak yazılım seviyesindeki optimizasyonlar tükendiğinde gerçek anlamda gerekli hale gelir. Bu sıralama — önce optimize et, sonra büyüt — hem maliyeti kontrol altında tutar hem de gereksiz altyapı karmaşıklığından kaçınmanızı sağlar.
Özetle: prototipten üretime GPU VDS ile başlayın, trafik büyüdükçe paket yükseltin veya yatay ölçeklendirin; model boyutu veya paralel eğitim ihtiyacı tek GPU'nun sınırlarını aştığında Fiziksel GPU Sunucu'ya geçin.
GPU VDS, quantization, LoRA fine-tuning ve KVKK uyumu hakkında en çok sorulan sorular.
GPU destekli VDS'te model eğitimi ve çıkarım için altyapı.
Paylaştırılmış NVIDIA GRID ekran kartıyla model eğitimi ve inference işlerinizi hızlandırın.
Popüler makine öğrenmesi kütüphanelerini kurup kendi modellerinizi eğitin.
Yerel LLM çalıştırma, veri işleme ve render gibi GPU gerektiren işleri tek sunucuda toplayın.
Sunucularınız, Uptime Institute Tier III ve ISO 27001 sertifikalı DataCasa İstanbul veri merkezinde barındırılır; yedekli (N+2) enerji altyapısı ve 7/24 fiziksel güvenlik DataCasa'nın sunduğu standartlardır.
VDS & VPS Rehberi
Zapier'in task bazlı faturası mı, n8n'in sabit VDS maliyeti mi daha mantıklı? Sayılarla, kurulum adımlarıyla ve gerçek senaryolarla karşılaştırdık.
VDS & VPS Rehberi
VDS'te Postfix ve Dovecot ile kendi mail sunucunuzu nasıl kuracağınızı; DNS, SPF/DKIM/DMARC, TLS ve güvenlik ayarlarıyla adım adım öğrenin.
VDS & VPS Rehberi
MT4/MT5 terminal sayısı ve EA yoğunluğuna göre forex VDS'inizi doğru boyutlandırmak için RAM, CPU ve disk gereksinimlerini somut rakamlarla anlatıyoruz.
İhtiyacınıza en uygun çözümü seçin
NVIDIA GRID GPU sanal sunucu.
İnceleFiziksel GPU sunucu kiralama.
İnceleTam donanım kontrolü, dedicated server.
İnceleE5-V4 / E5-V2 nested virtualization destekli VDS.
İncele PopülerLiteSpeed + CloudLinux + cPanel altyapısı.
İnceleE-ticaret için optimize VDS.
İnceleSelf-hosted n8n için optimize VDS.
İnceleTüm VDS paketlerine genel bakış ve fiyatlar.
İncele